När jag skrev om hur jag kör flera AI-agenter parallellt berättade jag att jag redan då kunde vara mentalt slut vid lunch. Det var en av anledningarna till att jag valde att bygga Norns Companion. Nu har jag använt Companion i över ett halvår, och jag känner fortfarande samma trötthet ganska regelbundet.
Verktyget gör det jag byggde det för. Jag ser vilka agenter som väntar, jag kan godkänna utan att byta session och ingen agent står stilla för att jag missade ett beslut som väntar på mitt svar. Men tröttheten verkar sitta någon annanstans än i att hålla koll på agenterna.
Är jag då ensam om denna upplevelse?
Under våren kom flera undersökningar om samma sak. Boston Consulting Group frågade 1 488 anställda i USA och kallar fenomenet AI brain fry, en mental trötthet som uppstår när arbetet med AI kräver mer än man orkar hålla i huvudet. De som övervakade AI-verktyg i hög grad rapporterade 12 procent mer mental trötthet och 19 procent mer informationsöverbelastning. Forskarna skiljer det från burnout, som byggs upp under lång tid. Det här är en mer akut trötthet som sitter i tänkandet och som påverkar förmågan att fatta beslut.
Stack Overflow skrev i maj om samma sak ur utvecklarens perspektiv: agenterna skriver koden snabbare, men besluten om koden har blivit fler. När jag läste den kände jag igen mycket av mig själv i den artikeln. Jag skriver inte längre mycket av koden själv, men besluten om hur den ska utformas och vad som är definition of done är fortfarande mina.
Vad Companion löste och vad som blev kvar
Companion löste överblicken av arbetet. Frågan om vilken agent som väntar på mig tar inte längre något tyngre fokus från mig. Det som tar energi är det som händer när jag väl är där.
För mig är det tre saker. Det första är besluten. Varje godkännande, varje val mellan två förslag och varje fråga om agenten har förstått uppgiften är ett litet beslut, och de dyker upp konstant under hela dagen. Det andra är code review av kod jag inte har skrivit själv. Detta kräver mer fokus för att jag ska kunna skicka det hela till produktion. Det tredje är växlingen mellan parallella sessioner. Companion gör vägen dit kort, men att sätta sig in i ett annat projekts aktuella status kostar ändå, även när jag vet exakt vart jag ska.
Så varför plågar jag mig själv med att reviewa koden?
Code review är den del jag har svårast att släppa, och jag tror inte att jag någonsin ska släppa den helt. Om något händer i koden vill jag kunna säga att jag har läst den och förstår den. Jag vill också se att AI har valt vettiga sätt att lösa uppgiften, att den inte uppfinner nya lösningar där det redan finns en fungerande eller gör allt mer komplext än det behöver vara för att nå målet. Det märks mest när agenten och jag har byggt en hel sida med nya komponenter eller ändrat i legacy kod där QA växer med ändringen.
Det finns stöd för att det är just granskningen som tar kraft och energi. I en studie från CHI 2026 löste 60 deltagare programmeringsuppgifter med och utan AI-assistent. AI:n sänkte belastningen och gjorde dem snabbare, men den stress och trötthet som växte uppgift för uppgift förklarades delvis av arbetet med att verifiera AI:ns output.
Vad jag har provat
Så vad har jag gjort för att minska belastningen?
Jag lade tid på att lära mig auto mode och vad i config som behöver vara korrekt för att Claude Code bara ska få köra på, och jag har förgodkänt de kommandon som ändå alltid blir godkända. Agenten behöver inte längre stanna och vänta på mig hela tiden. Jag slipper en ström av notiser som kallar på mig, och jag behöver inte agera med ojämna intervaller under hela dagen. Det avlastar faktiskt en hel del.
Till code review kör jag Codex och GLM 5.3 som reviewers i en separat session. Jag skickar synpunkterna fram och tillbaka tills jag känner att det är dags att titta själv. Men jag läser fortfarande själv till slut, av skälen ovan.
Jag har också provat att låta Claude Opus leda en grupp billigare Sonnet 5-agenter som sedan gör själva bygget. I praktiken kunde en uppgift som Opus och jag löser på vanligt sätt ta dubbla tiden. Agenterna fastnade i review-rundor och åtgärder som en starkare modell hade löst själv. Det skapade extra stress och inte den magiska känslan av att bara låta den rulla tills det hela är klart.
Jag har också bytt output style i Claude Code. Där kan jag välja mellan Default, Proactive, Concise, Explanatory och Learning, där Concise svarar kortfattat, börjar med resultatet och hoppar över inledningar och berättande.
För mig verkar Concise vara the sweet spot. Den laddar fortfarande skills som till exempel brainstorming, men avgör sedan själv att en del uppgifter klarar sig utan en större planering först. Det är skönt på mindre uppgifter och sparar både tid och output.
Det auto mode förde med sig
Färre avbrott betyder inte att det blir mindre att ta ställning till. När agenten får köra längre utan mig kommer det tillbaka mer text: sammanfattningar, planer, förklaringar och dokumentation. För mig känns det som att belastningen har flyttat från att godkänna till att läsa.
Ber jag en agent dokumentera något blir det lätt två sidor av dokumentation. Det fungerar inte att skicka två sidor till en PM som behöver en kort lista att dela med kund. Samtidigt är den tyngre dokumentationen precis vad nästa agent behöver för att kunna fortsätta arbetet. Det är samma innehåll, men för två helt olika läsare.
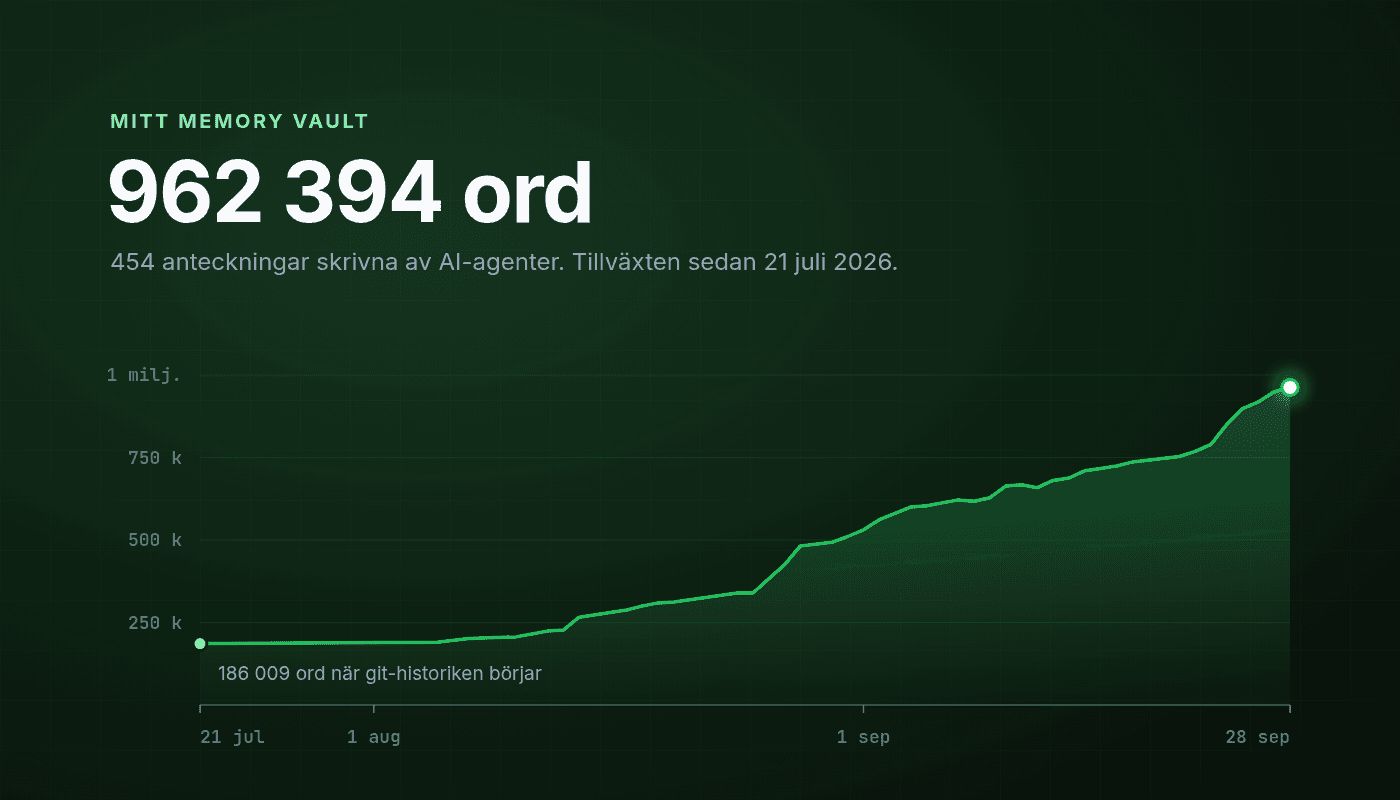
Det syns tydligast i mitt memory vault, där agenterna loggar arbetet i kundprojekten. Det är byggt för att nästa agent ska kunna ta vid: en mapp per kund, frontmatter på varje fil och en instruktionsfil som talar om hur allt ska skrivas. Sedan juli har det vuxit från knappt 200 000 till nästan en miljon ord, i över 450 anteckningar. En vanlig supportanteckning är runt 1 000 ord, ungefär två sidor. För en agent är det precis rätt underlag.
För mig, när jag ska svara en kund eller stämma av med en PM, är det mer än jag hinner läsa varje gång.
Lagom, rätt output för rätt läsare
Så jag byggde en skill för läsandet. Jag kallar den lagom, eftersom det som är lagom beror på vem som är mottagare.
Den tar en text, en anteckning eller agentens senaste svar och gör en kort version för en av två mottagare: mig själv eller en PM.
Jag kan anropa den med /lagom, men den laddas också när jag bara ber om en kort version till PM:en.
Till mig blir det några punkter där det jag behöver ta beslut på kommer först. Till PM:en blir det en kort lista med läget, vad vi behöver från kunden och vad som kan gå fel, utan sökvägar och tekniska förklaringar.
Själva underlaget rörs aldrig. Den tunga dokumentationen finns kvar för nästa agent, och den korta versionen tas fram ur den.
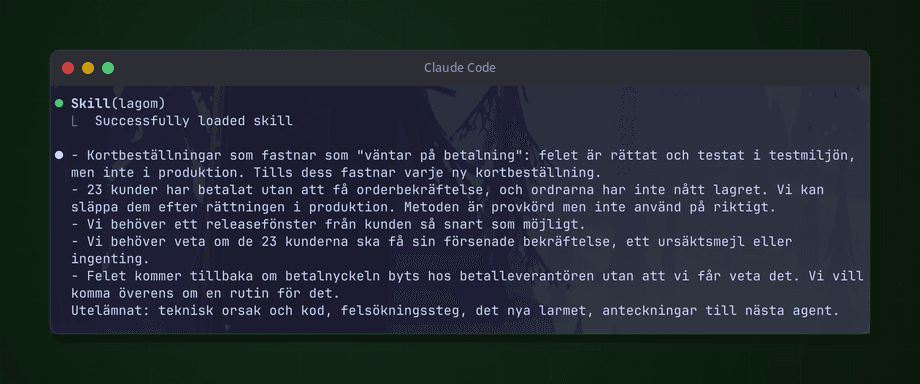
Innan lagom skrevs lät jag agenter utan den korta ner samma texter, för att se vad som faktiskt gick fel. Resultatet är intressant att dela med mig av. Innehållet var redan försiktigt: en annan kund som nämndes i underlaget kom aldrig med, testmiljö och produktion hölls isär och inga datum hittades på. Det som gick fel var formen. En kort version till PM:en blev drygt 300 ord och ett färdigt brev till kunden, med ämnesrad och hälsning. En status på 46 ord blev ett mejl på över hundra ord, signerat med mitt namn.
Med lagom blev samma supportanteckning fem punkter och runt 95 ord, och den redan korta statusen fick vara som den var.
Jag jämförde också med Caveman, en populär skill som får agenten att svara i korta fragment för att spara tokens. JetBrains har mätt den till 8,5 procent färre output-tokens i agentarbete, utan mätbar kvalitetsförlust.
I mitt test ändrade den ingenting för PM:en, eftersom dess egna regler säger att text till andra människor ska skrivas i vanlig prosa. Till mig blev svaret till och med längre än utan skill, eftersom allt innehåll fanns kvar i kortare meningar.
Caveman och lagom löser alltså olika saker. Den ena kortar meningarna, den andra utgår från vem som ska läsa.
Det här var ett litet test på påhittat material, en eller två körningar per fall. Det visar formen, inte att skillen håller i det dagliga arbetet.
Samma tempo utan att bränna ut mig
Det enklaste rådet vore att köra färre agenter samtidigt. Det är också det enda jag inte har provat. När jag bara sitter och väntar på att en agent ska bli klar blir jag rastlös, och då är det nära till hands att starta upp något annat för en annan kund. Parallella sessioner är alltså inte bara något jag står ut med, de är också mitt sätt att hantera väntan.
Jag verkar inte vara ensam. I en ny, ännu inte granskad studie från ETH Zürich och Zürichs universitet beskrev deltagarna samma två vägar när AI:n genererar: antingen sitter man overksam, eller så byter man uppgift och betalar för det när man ska tillbaka. Forskarnas slutsats är att väntan i AI-verktyg borde designas, inte bara stås ut med.
Jag vill heller inte sänka tempot eller mängden jag får gjort på en dag. Det jag letar efter är ett sätt att hålla samma tempo utan att bränna ut mig. Lagom är mitt första försök att göra något åt läsandet. Om den gör skillnad i vardagen vet jag inte än. Jag återkommer när jag har använt den ett tag i riktiga projekt.